NVIDIA NIM 免费 API:43 个免费端点,DeepSeek 与 GLM 免绑卡直调
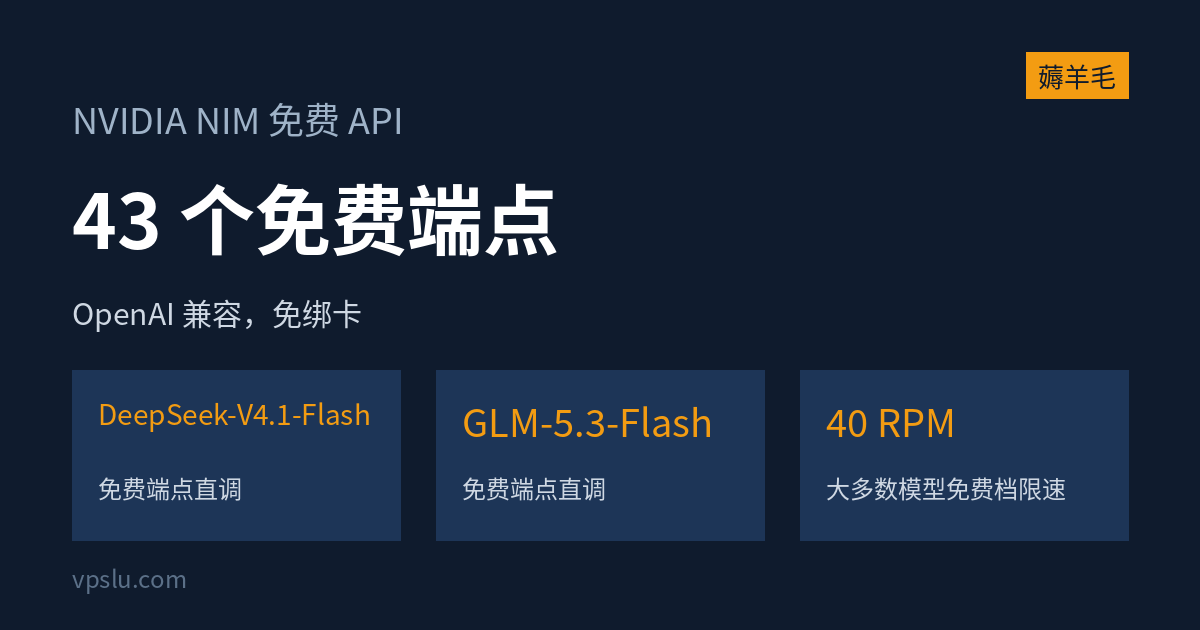
NVIDIA 的 build.nvidia.com 上挂着一批免费 API 端点:注册账号、生成一个 API Key,就能按 OpenAI 兼容格式直接调用,不用绑卡。11 月 14 日核对时,模型列表页共 103 个模型,其中标着 Free Endpoint 的有 43 个,覆盖对话、推理、解析、重排、嵌入好几类。
能调什么
国内读者最熟的三个都在:DeepSeek-V4.1-Flash、GLM-5.3-Flash、MiniMax-M3.1-Flash,模型页都写着 Start building with a free API endpoint,调用示例就是 OpenAI SDK 的写法。模型 ID 按官网页面分别是 deepseek-ai/deepseek-v4.1-flash、z-ai/glm-5.3-flash、minimaxai/minimax-m3.1-flash。其余带 Free Endpoint 标记的还有 Mistral Large 4 和 Nemotron 3.5 系列的解析、重排、嵌入与推理模型,文本、图文输入、工具调用、结构化输出都覆盖。免费端点数量随上下架变,43 个是 11 月 14 日的数,用之前以官网列表页实时状态为准。
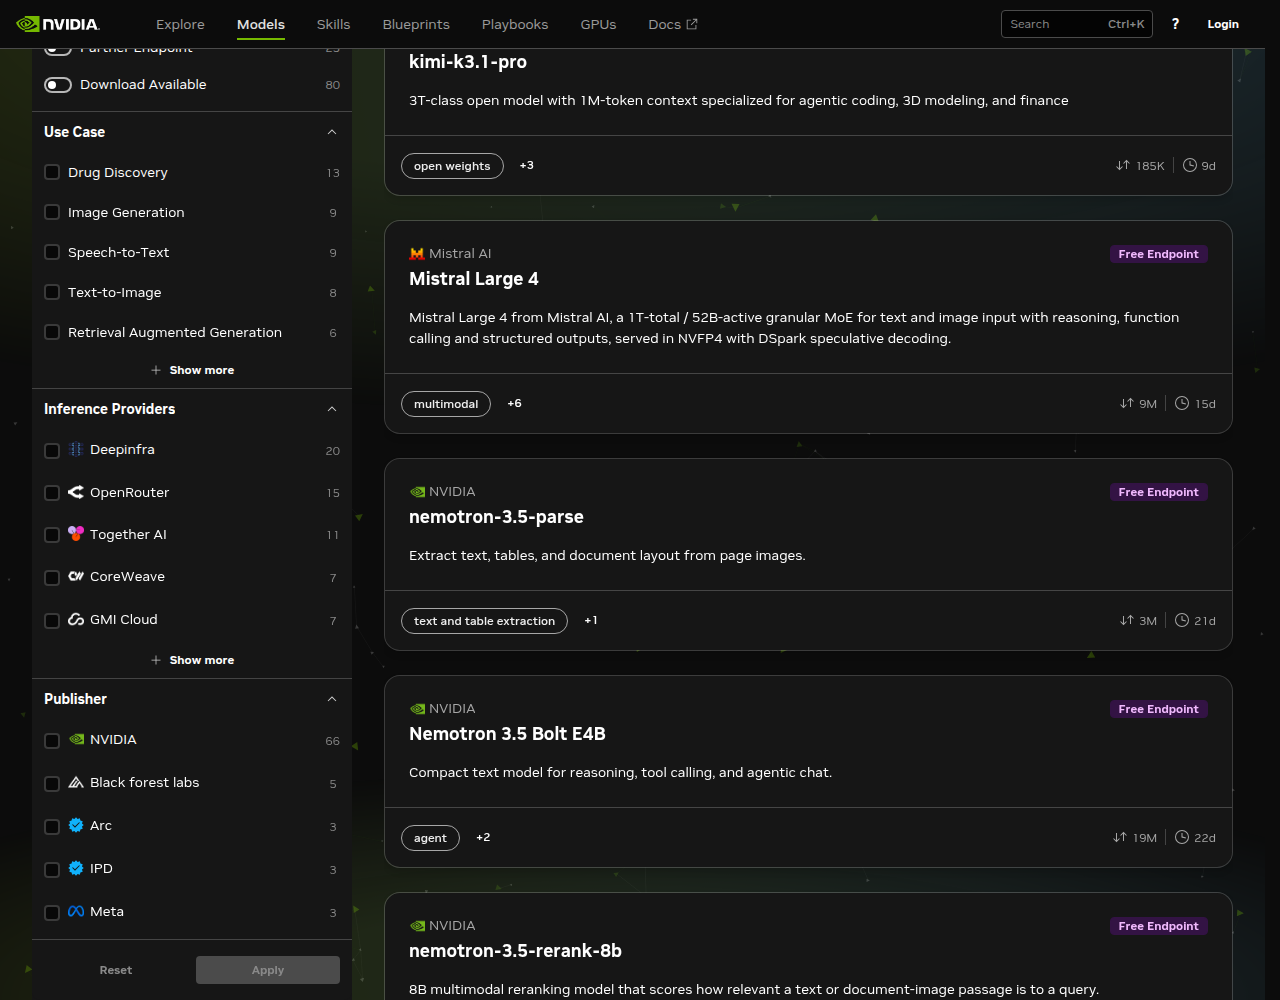
图源:NVIDIA build.nvidia.com 模型列表页截图,2026-11-14
调用方法
三步。第一步,注册并登录 NVIDIA 账号,打开模型列表页。第二步,进任意一个带 Free Endpoint 标记的模型页,点 Generate API Key 生成密钥并保存好。第三步,按 OpenAI 兼容格式调用:Base URL 填 https://integrate.api.nvidia.com/v1,model 填上面那种完整模型 ID,其余写法和 Chat Completions 接口一样,现有代码基本只改地址和模型名就能跑。官方示例有 Python、Node、Shell 三种,模型页上直接能抄。
限制先说清楚
免费的意思是免费用来做原型验证,不是生产额度。官方帮助文档写明:免费档按速率限制走,大多数模型上限每分钟 40 次请求(40 RPM),不按 Token 计费;个人具体限速显示在控制台右上角,超过就返回限流错误。官方 FAQ 原话是 All models on build.nvidia.com are free to prototype with,撞上限后官方指的路是去 Deploy 栏目走合作方端点,或本地部署 NIM 容器。拿它跑日常小工具、接 Agent 测试没问题,指望它扛生产流量不现实。单个模型也可能下线,调之前看一眼模型页状态,别把关键路径押在随时可能下线的端点上。
和站内文章比
站内写过两个能对照的:一个是LG EXAONE API 免费开放,单家模型,每天 86,400 次调用,适合认准一个模型长期用;一个是NVIDIA 开发者计划免费 DLI 实操课,那是免费课,和这篇的免费 API 不是一回事。NIM 的特点是模型多、一个 Key 通调,代价是每个模型 40 RPM 上下的限速:要一个模型稳定大量调,看 EXAONE 那篇;要一次试十几个模型的手感,用 NIM。
使用前须知
第一,免费端点不用绑卡,但要注册 NVIDIA 账号,注册环节以官网实时流程为准。第二,免费档大多数模型限速每分钟 40 次,且官方写明限速因模型、用途和平台负载而异,控制台右上角的个人限速才是准数,别拿 40 当保证值。第三,免费端点只供原型验证和评估,生产用途要走付费部署。第四,43 个免费端点、103 个模型总数是 11 月 14 日核对时的列表状态,上下线后会变,三个模型 ID 以模型页实时内容为准。第五,本文未实测注册与实际调用,规则核对日期 2026 年 11 月 14 日,以官网实时页面为准。
出处:NVIDIA build.nvidia.com 模型列表页
 微信扫一扫,打开后点右上角转发