AMD 官方免费模型 API:Radeon Cloud Token Factory 每日额度 0 点重置,双协议接入
AMD 的 Radeon Cloud 是 AMD 自家的 GPU 云平台,除了按小时计积分的 GPU 实例,里面还有一个常驻免费的部分叫 Token Factory:一批模型托管在 Radeon GPU 上,通过 API 直接调用,不用启动实例,不消耗积分,拿到 API Key 就能发请求。这个服务只在中国站提供,官方文档写得很齐:接口、额度、限流、条款都有明文。打算拿免费模型 API 做日常开发和 Coding 的,这篇按官方文档把关键数字一次说清。
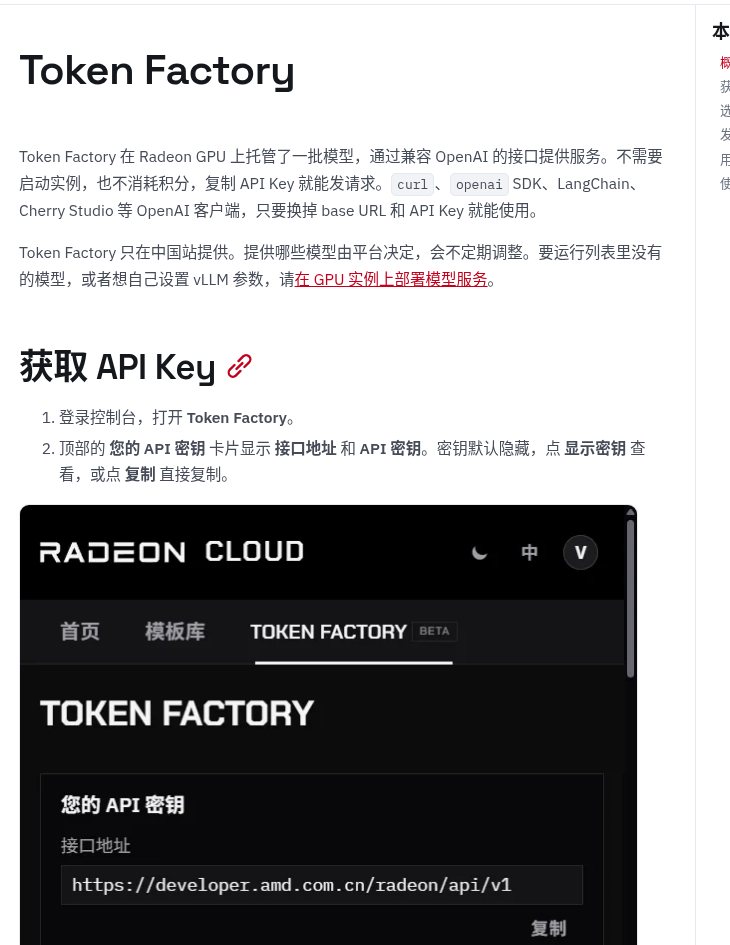
图源:AMD Radeon Cloud 官方文档截图
Key 怎么拿,接口长什么样
入口是 developer.amd.com.cn/radeon/tokenfactory。用 AMD AI 开发者计划账号登录控制台,打开 Token Factory,页面顶部的「您的 API 密钥」卡片里就是接口地址和 API Key:Key 以 rc- 开头,第一次打开这个页面时自动生成,不需要提交申请等审核。密钥默认隐藏,点显示或复制即可。一个 Key 通调 Token Factory 里的全部模型,换模型只改请求里的 model 字段。官方文档还专门提醒保管好这个 Key:谁拿到它,谁就能用掉你的每日用量,泄露了可以在控制台轮换。
接口地址是 https://developer.amd.com.cn/radeon/api/v1。主要接口有五个:POST /v1/chat/completions 是兼容 OpenAI 的聊天补全;GET /v1/models 列出当前可调用的模型;POST /v1/messages 是兼容 Anthropic 的 Messages 接口,文档明说供 Claude Code 等客户端使用,配套还有一个 /v1/messages/count_tokens;GET /v1/usage 查自己当天的用量和剩余额度。也就是说,curl、OpenAI SDK、LangChain、Cherry Studio 这类 OpenAI 客户端换掉 base URL 和 Key 就能接,Claude Code 走 Anthropic 协议那条线。一个细节:请求先过网关,网关只认一组固定字段,不在字段集里的参数会被直接丢弃而不是报错,从别的平台搬配置过来时,某些参数不生效多半是这个原因。
模型目录:平台说了算,且会变
Token Factory 提供哪些模型由 AMD 决定,官方文档原话是会不定期调整。控制台里的目录可以按用途、推理提供方、发布方筛选,每张模型卡片会显示这个模型当前是否繁忙、价格和调用时要填的 model 值;文档里的调用示例用的是 DeepSeek-V4-Flash。官方 FAQ 对这件事的态度很明确:模型列表会变,不要把模型名写死在代码里,先看目录或者调一次 GET /v1/models 再用。目录里也不只有聊天模型,还有语音合成这类按输入字符计价的模型(例如 OmniVoice,按每百万字符标价)。所以评估这个服务的方法不是数「现在有几款模型」,而是把它当成一个平台维护的滚动目录:今天的主力模型以控制台为准,写自动化脚本的先做一次模型列表查询再发请求。
额度是 pts 制,不是固定 token 数
免费的代价是每日用量上限。计量单位叫 pts:每个模型按每百万 token 标价(文档示例是 0.14 pts / 1M tokens),调用按实际用量扣 pts,累计到账号当天的上限为止,每天北京时间 0 点(UTC+8)按自然日重置。pts 只用来计量,不是费用,也和开 GPU 实例用的积分是两回事。需要注意的是,官方文档没有公布一个全网统一的每日 pts 数字:用量接口文档里的示例显示上限为 10 pts,但同一页明确标注这只是示例,不同账号的限额不一样,而且会调整。想知道自己的额度,看控制台的「积分与用量」页面,或者调 GET /v1/usage;每次请求的响应头里也会带当天的上限、已用和剩余。用完之后请求会被拒绝,要等 0 点重置,跑批量任务之前先查一眼剩余额度,免得跑到一半断掉。
限流:两层,数字不高
限流分平台准入和网关计量两层,各自独立生效。平台准入:每个 API Key 每分钟 30 次请求、并发 8 个;每个 IP 地址每分钟 120 次。网关计量:每个账号每分钟 20 次,按 60 秒滑动窗口算;每日用量上限也在这一层。聊天、语音合成、决策三类请求共用同一个每分钟窗口和同一个每日上限。超限返回 429 并带 Retry-After 响应头。个人开发、日常对话和 Coding 辅助,这个量级够用;想拿它跑并发批处理,先被限流教会做人。
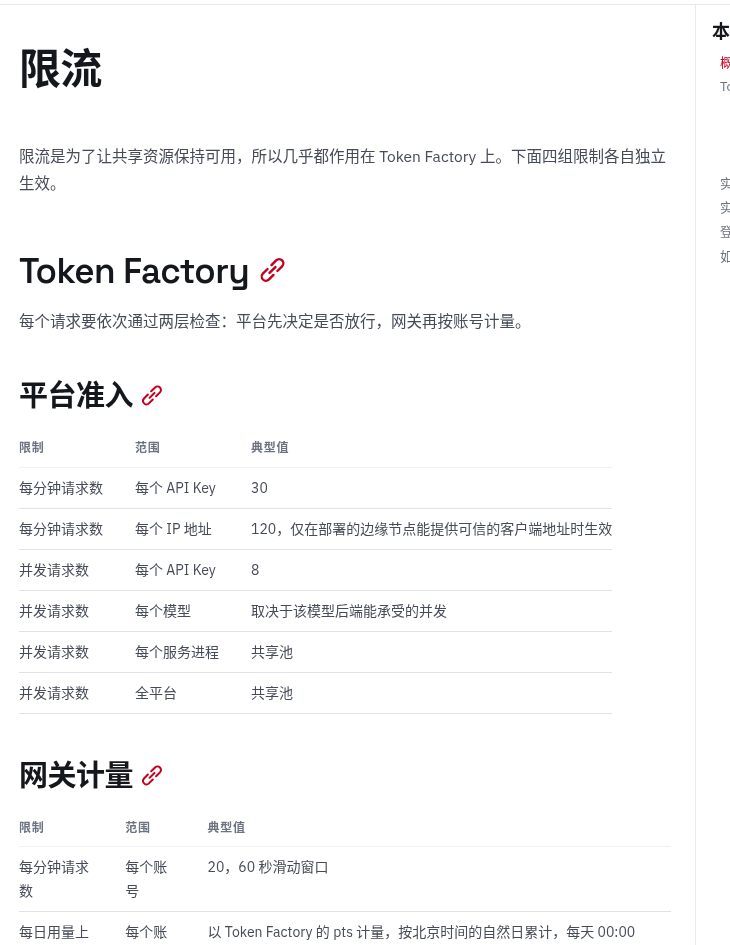
图源:AMD Radeon Cloud 官方文档截图
和本站此前写过的两个免费额度对比一下。IFM 的每日 1000 万 Token 是固定 token 口径,数字确定、查都不用查,但模型范围以自家为主;AMD 这边胜在目录是多家模型滚动供给、双协议通吃,而且是大厂官方的常驻服务,没有活动截止日,代价是额度要按 pts 折算、还因账号而异。Command Code 的免费模型则是限时窗口,本周内就到期,和这种常驻服务不是一个用法:短期尝鲜随意,长期挂在 Cherry Studio 或 Claude Code 里当日常供给的,选常驻的这家更合理,但要接受它的目录和额度随时可能被平台调整。
购买前须知
第一,服务定位写在官方条款里:Token Factory 是免费的试用和开发服务,不适合生产环境,且禁止转售访问权限。拿它做个人项目和开发调试正合适,正经生产服务不要往上放。第二,模型目录动态调整是官方明示的规则,写代码前先调 GET /v1/models 确认模型在不在、model 字段填什么,不要照着任何一篇攻略里的名单写死,包括本站这篇提到的示例模型。第三,每日 pts 上限因账号而异,本文和官方文档里的示例数字都不构成承诺,自己的上限以控制台「积分与用量」和 /v1/usage 接口返回为准。第四,限流是每 Key 每分钟 30 次、并发 8、账号每分钟 20 次的组合,自动化任务请按这个量级设计重试和间隔,超限会收到 429。第五,API Key 等于额度本身,拿到 Key 的人能用掉你当天的全部用量,不要把 Key 写进公开仓库或截图里,轮换方法见官方文档的认证页。第六,这个服务仅在中国站提供,账号体系是 AMD AI 开发者计划;官方文档没有提出绑卡要求,GPU 实例那部分用的积分兑换与 Token Factory 无关,别混为一谈。第七,本文为资料整理,内容为 2026 年 11 月 1 日在 AMD Radeon Cloud 官方文档核对的结果,笔者未注册实测,实际模型目录与个人额度以注册后控制台显示为准。
 微信扫一扫,打开后点右上角转发